新闻动态
AI手机智能体实测成绩单出炉: 中兴领跑商用赛道, 端侧小模型集体遇阻
[CNMO科技消息]当智能手机硬件创新进入瓶颈期,GUI智能体正成为手机厂商新一轮角逐的核心赛场。从传统语音助手到具备自主规划、视觉感知、跨应用全链路执行能力的智能体,端侧AI的落地能力,已然成为划分产品竞争力的核心标尺。近日,SuperCLUE发布AgentCLUE-Mobile6月手机助手GUI智能体测评榜单,6款主流手机智能体同台竞技,最终成绩呈现出“一家领跑、三家胶着、两家追赶”的清晰格局。测评数据直指当下行业真相:参数并非决定性能的唯一标准,模型架构、任务适配度、单步决策质量,才是AI手机迈向商用的关键。
一、榜单全景:三大梯队泾渭分明,中兴实现断层领先
本次测评聚焦具备完整智能体架构与专属模型的6款产品,统一在ADB手机交互+纯视觉输入的标准化环境中开展测试,从意图解析、视觉感知、长链路执行三大核心维度量化能力,最终总成绩排名如下:
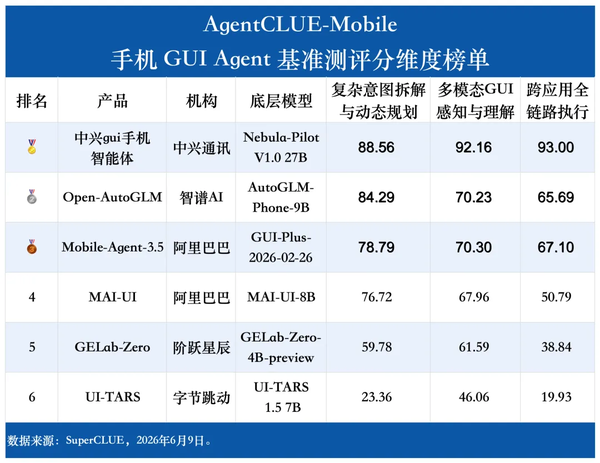
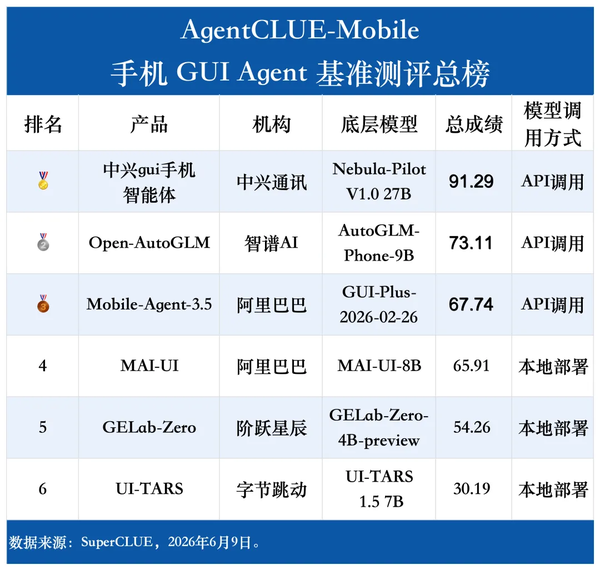
结合分数与综合能力,6款产品被划分为三大梯队,差距十分显著:
1.第一梯队(90分以上,商用级):仅中兴GUI手机智能体入围。91.29分的总成绩遥遥领先,也是全场唯一综合能力接近商业落地标准的产品。其在简单、中等、困难全难度任务中表现稳健,7大细分维度得分均突破85分,端到端任务完成率高达93%,基本摆脱了端侧智能体“指令理解偏差、操作冗余、长链路中断”的通病。
2.第二梯队(65-75分,成长型):智谱AIOpen-AutoGLM、阿里两款产品形成中游阵营,三款产品分差不足8分,处于胶着状态。该梯队产品具备基础的意图解析与GUI感知能力,但跨应用长链路执行成为普遍短板,任务完成率集中在56%-60%,距离规模化商用仍有明显差距。
3.第三梯队(60分以下,探索型):阶跃星辰GELab-Zero、字节跳动UI-TARS处于追赶阶段。其中UI-TARS以30.19分垫底,与榜首差距超60分,纯视觉小模型在复杂手机交互场景中的能力短板暴露无遗;GELab-Zero虽优于UI-TARS,但整体能力薄弱,全维度得分均低于62分,任务完成率仅35%。
从调用模式来看,API调用类产品整体表现优于本地部署产品。榜单前四名中三款均采用云端API调用,而四款本地部署产品包揽后三名。这也印证了当前行业现状:受限于手机端算力、内存、功耗,纯端侧本地运行的小模型,暂时难以承载复杂GUI自动化任务,端云协同仍是现阶段最优解。
二、深度拆解五大核心结论:云端还是本地大模型?这是一个问题。
本次测评并非简单的分数排名,而是通过难度分层、步骤拆解、多维度打分,挖掘端侧GUI智能体的技术瓶颈与行业趋势,五大核心结论精准勾勒出当前赛道的技术全貌。
1.难度表现分化:部分产品“倒错配”,中等任务成最大考验
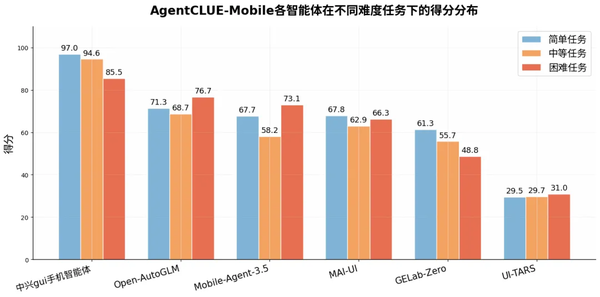
测评题目采用倒金字塔难度结构,困难题目占比最高,重点考验智能体的长链路执行、多意图并行、异常恢复能力。各产品在不同难度任务中的表现,颠覆了“难度越高、得分越低”的常规认知:
中兴实现全难度通吃:简单任务得分96.99分,困难任务仍保持85分以上,无论短指令还是多步骤复杂任务,决策稳定性拉满。
第二梯队两款产品出现难度逆序现象:Open-AutoGLM困难任务得分76.71分、中等任务68.68分;Mobile-Agent-3.5困难任务73.09分、中等任务58.17分。困难任务得分反超中等任务,核心原因是中等任务包含大量隐式指令、多意图并行判断,对模型的规划稳定性要求更高,反而比线性长链路的困难任务更难应对。
第三梯队全线拉胯:MAI-UI、GELab-Zero遵循得分随难度递增递减的规律,但整体分值偏低;UI-TARS更为极端,简单、中等、困难三类任务得分均徘徊在30分左右,属于“全难度失效”,无法胜任基础手机自动化操作。
2.执行效率:完成率与操作步数强绑定,冗余操作是体验硬伤
测评从任务完成率和平均操作步数两大维度,衡量智能体的执行效率,这也是直接影响用户体验的核心指标:
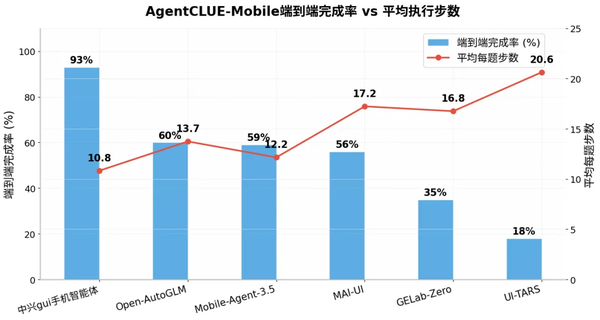
中兴:93%的超高完成率,平均每题仅10.83步。单步决策精准,几乎无冗余点击、回退操作,执行效率、准确率双优,完全适配日常用户使用场景。
第二梯队:完成率集中在56%-60%,步数差异明显。Mobile-Agent-3.5(59%/12.15步)效率相对均衡;MAI-UI完成率56%,平均步数高达17.23步,存在大量无效操作,呈现“操作多、正确率低”的问题。
第三梯队:陷入“步数越多、错误越多”的恶性循环。GELab-Zero完成率35%,平均16.75步;UI-TARS完成率仅18%,平均步数达到20.62步,相当于每执行11步才能成功一次,实用性极低。
行业规律在此得到验证:智能体的实用化瓶颈,不止是“能否完成任务”,更是“用多少步骤完成任务”。压缩无效操作、提升单步决策质量,远比单纯提升整体正确率更能优化用户体验。
3.云端模型断层领跑,本地小模型“参数越大未必越强”
模型架构与场景适配度,优先级远高于参数量:
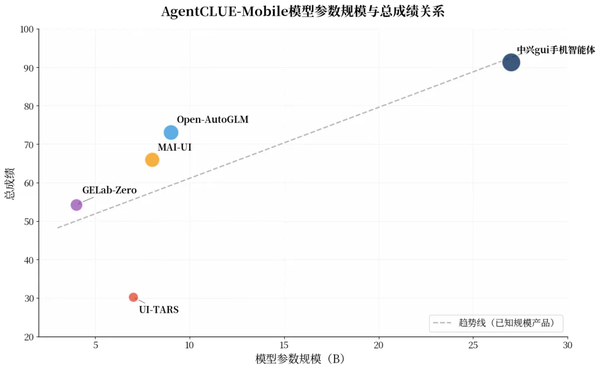
27B参数的中兴Nebula-PilotV1.0一骑绝尘,相较第二名9B参数的Open-AutoGLM拉开18分的巨大差距,大参数模型在复杂认知、长链路规划上的优势充分显现。
7B模型表现不及4B模型:字节UI-TARS(7B)得分30.19分,大幅落后于阶跃星辰GELab-Zero(4B,54.26分)。这证明脱离场景适配的参数堆叠毫无意义,针对手机GUI交互优化的小模型,能力可以超越通用型7B模型。
4B-9B参数区间出现边际效应递减:该区间内模型参数量提升带来的能力增益十分有限,厂商单纯依靠“堆参数”提升产品竞争力的路线已经走不通。
4.能力短板:跨应用执行成为行业通用瓶颈,短板决定上限
测评设置7大细分能力维度,热力图数据清晰展现各产品的能力矩阵,同时揭示了全行业的共性短板:
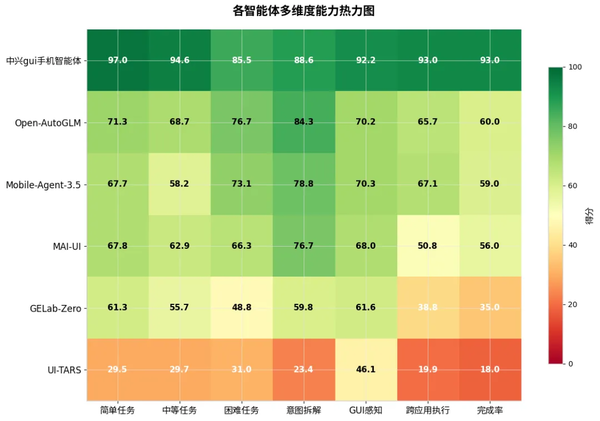
中兴:能力全面均衡,六大核心维度(简单/中等/困难任务、意图拆解、GUI感知、跨应用执行)得分全部突破85分,无明显短板,这也是其高完成率的核心支撑。
第二梯队:认知、感知能力尚可,但跨应用全链路执行集体拉胯。Open-AutoGLM、Mobile-Agent-3.5该维度得分分别为65.69分、67.10分,多应用切换、数据迁移、通知栏联动等复杂场景处理能力不足;MAI-UI分化严重,意图拆解得分76.72分,但跨应用执行仅50.79分,“认知强、执行弱”的问题突出。
第三梯队:全面落后。GELab-Zero全维度低于62分;UI-TARS仅GUI感知维度达到46.06分,其余维度均低于31分,纯视觉模型难以兼顾认知、规划、执行全流程。
总结来看:智能体的端到端成功率,由最弱维度决定。当下多数产品卡在“跨应用执行”环节,这也是从“玩具级AI”走向“工具级AI”必须攻克的核心关卡。
5.场景实战:典型任务落地对比,差距直观可见
本次测评选取多意图并行+跨应用执行的高频复杂任务作为典型案例:“高德搜索海底捞并导航至最近门店,打开微信在产品交流群发送位置共享”,完整还原用户真实使用场景,两款梯队代表产品的表现差距一目了然。
1.中兴GUI手机智能体(满分100分)
全程15步操作,每一步逻辑连贯、动作精准。依次完成打开高德、搜索关键词、按距离排序选择最近门店、启动导航、返回桌面、打开微信、进入群聊、开启实时位置共享,无一步冗余、无一次误操作,精准理解“最近门店”“位置共享(实时共享)”两大核心指令,完美匹配用户真实诉求。裁判判定所有步骤有效,是全场唯一满分完成该复杂任务的产品。
2.GELab-Zero(得分53.85分)
总计13步操作,出现两处核心错误:第一,搜索海底捞后,未选择距离最近的门店,违背“导航至最近一家”的指令;第二,混淆微信“发送静态位置”与“共享实时位置”功能,误选静态位置发送,偏离“位置共享”的核心要求。两大关键失误直接导致任务失败,大量操作沦为无效动作,也是中低端智能体的典型问题:指令理解浮于表面,无法区分相似功能、隐性约束条件。
该案例也直观解释了分数差距背后的用户体验差异:优秀的GUI智能体可以像人一样理解复杂自然语言、区分细节指令;而落后产品仅能完成基础点击,遇到多意图、隐性规则便容易出错。
三、总结:GUI智能体,重新定义下一代手机的核心体验
智能手机硬件创新已经触顶,摄像头、芯片、快充的同质化内卷难以再撬动换机需求,具备自主执行能力的GUI智能体,成为行业突破增长瓶颈的新变量。
本次AgentCLUE-Mobile测评交出了一份清醒的成绩单:当下国内手机智能体赛道梯队已然固化,中兴凭借自研27B大模型与深度场景优化,率先站在商用门槛之上;智谱、阿里等玩家处于成长阶段,仍需补齐长链路执行短板;而纯视觉小模型路线遭遇明显瓶颈。
对于整个行业而言,这场测评敲响了警钟:AI手机的竞争,早已不是“有没有大模型”的概念之争,而是“模型能不能用、用得好不好”的落地之争。参数只是数字,架构、适配、工程能力、场景打磨,才是决定产品最终体验的核心。
站在行业拐点之上,AI手机大战才刚刚开始。短期来看,端云协同仍是主流,全面商用的产品将率先收割市场;长期来看,随着端侧算力持续升级、模型技术不断迭代,本地部署的轻量化高性能智能体,或将成为最终形态。